



 Platform Architecture
Feel the Pulse of Your Infrastructure - Per-Second Visibility at Any Scale
Experience true real-time observability that scales with you, not against you. Netdata maintains per-second granularity and sub-2-second latency whether you’re monitoring 10 nodes or 100,000 - delivering 90% cost reduction and 80% MTTR improvement through revolutionary edge-native intelligence.

Real-Time Intelligence That Scales Linearly
Six core advantages that transform observability at scale
True Per-Second Everywhere
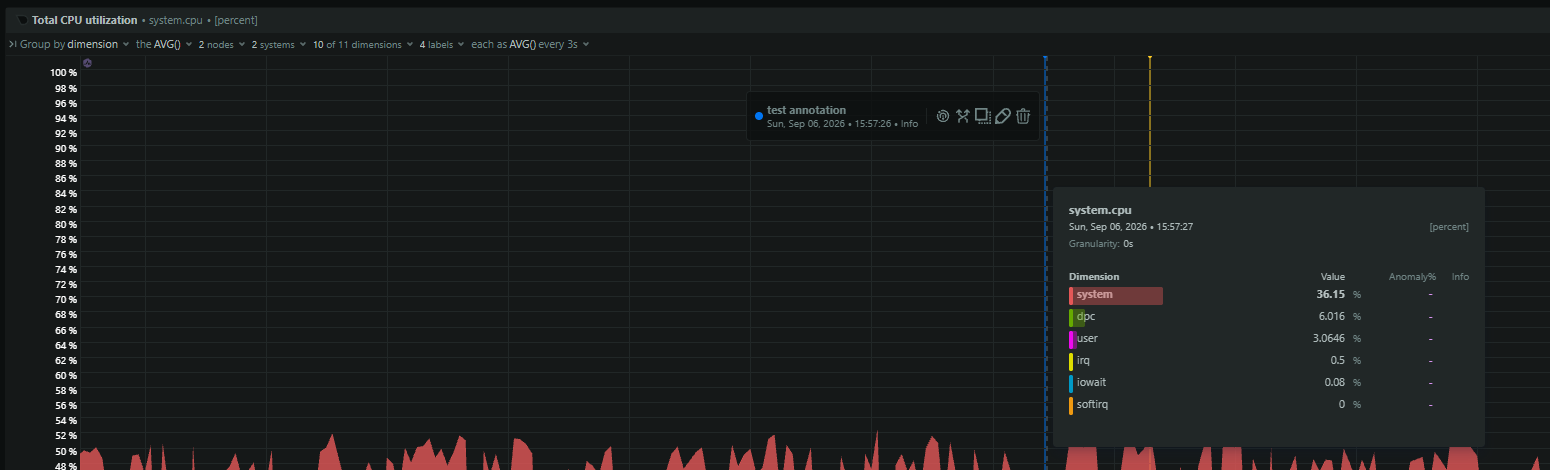
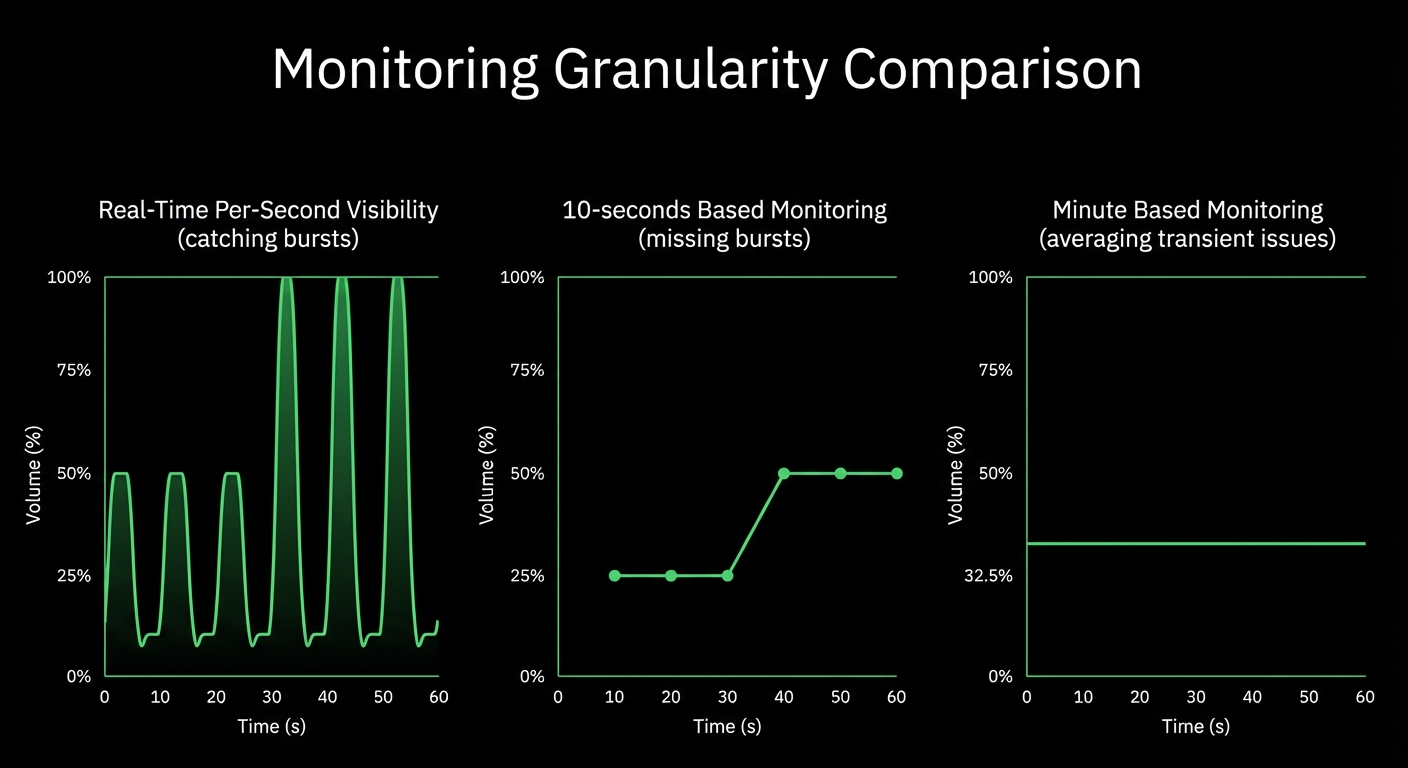
Fixed 1-second collection and visualization latency across all nodes - catch transient issues invisible to minute-averaging systems
Unlimited Cardinality by Design
Monitor ephemeral containers, microservices, and dynamic workloads without dimension limits or performance degradation
Sub-2-Second Total Latency
From event to insight in under 2 seconds - enabling rapid iteration during incidents and immediate change validation
90% Cost Reduction
Per-node pricing with no per-metric charges eliminates volume-based anxiety - predictable costs that scale with infrastructure value
Linear Performance Scaling
Adding nodes adds capacity, not complexity - same speed at 100 nodes or 100,000 through distributed edge architecture
80% MTTR Improvement
Anomaly Advisor surfaces relevant metrics from thousands - root cause in top 30-50 results enables resolution in minutes, not hours
Trusted by operations teams managing infrastructure at scale







Scale Without Compromise
See Every Heartbeat Without Breaking Your Budget
90% cost reduction vs. traditional platforms
Explore Cost Efficiency
Catch Problems Before They Cascade
10-60× more granular than traditional monitoring
Learn About Algorithmic Dashboards

Scale Beyond Prometheus Limits
4.5+ billion metrics/second globally
Compare with Prometheus


Resolve Incidents in Minutes, Not Hours
80% MTTR reduction
Discover AI Troubleshooting


Empower Every Engineer With Expert-Level Visibility
60 seconds from install to insight
Experience Zero Configuration

Monitor Everything Without Cardinality Anxiety
0.6 bytes per sample storage efficiency
Understand Tiered Retention


Real-Time at Scale: How Netdata Compares
Architectural Advantages That Matter
Traditional monitoring solutions face exponential complexity and cost at scale. Netdata’s distributed edge architecture delivers linear scalability with predictable economics - proven at billions of metrics per second globally.
Capability
Netdata
Traditional Monitoring
Data Granularity
✅ Per-Second
Fixed 1-second collection and visualization
⚠️ Per-Minute
10-60 second intervals miss transient issues
Total Latency
✅ Sub-2-Second
Guaranteed event to insight latency
⚠️ Minutes
Collection delays plus pipeline processing
Scalability Model
✅ Linear
Adding nodes adds capacity, not complexity
❌ Exponential
Central bottlenecks degrade performance
Cardinality Limits
✅ Unlimited
Built-in protections prevent cascading failures
❌ Constrained
8M series limit (Prometheus) or crashes
Pricing Model
✅ Per-Node
Predictable per-node pricing, no metrics volume charges
❌ Volume-Based
Per-host plus per-metric plus features
Data Sovereignty
✅ Edge-Native
All data stays local until viewed
❌ Centralized
Data leaves infrastructure for processing
Configuration Required
✅ Zero
Auto-discovery and algorithmic dashboards
⚠️ Extensive
Manual setup, PromQL, dashboard building
ML Anomaly Detection
✅ Every Metric
18 models per metric, automatic training
⚠️ Selected Metrics
Manual configuration or premium features
Storage Efficiency
✅ 0.6 Bytes/Sample
Industry-leading compression enables years retention
⚠️ 2-16 Bytes/Sample
Higher storage costs limit retention
Recovery Time
✅ Seconds
Instant restart, no WAL replay
❌ 15+ Minutes
Prometheus WAL replay creates blind spots
Architectural Innovations That Enable Scale
Process Where You Collect
Every Netdata Agent is a complete observability engine - collecting, storing, analyzing, and serving data locally. This distributed architecture eliminates centralization bottlenecks, reduces costs through zero egress charges, and enables linear scalability proven at billions of metrics per second globally.
Distribute the code, instead of centralizing the data
Explore Edge Architecture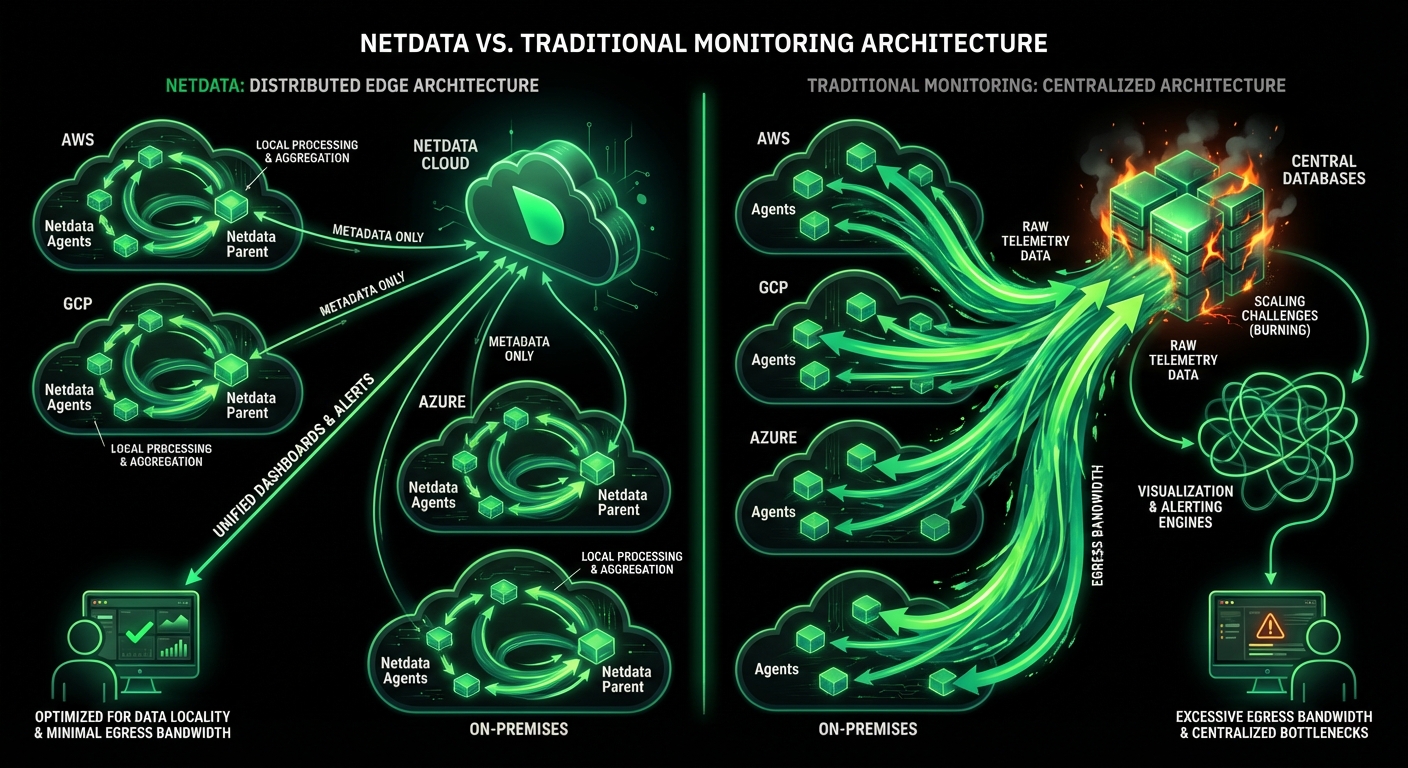


Real-Time at Scale: Key Takeaways
Six transformative advantages that redefine observability at scale
True Per-Second Everywhere
Fixed 1-second collection and visualization latency across all nodes - catch transient issues invisible to minute-averaging systems while maintaining sub-2-second total latency from event to insight.
Linear Scalability Proven
Process 4.5+ billion metrics per second globally while maintaining performance - adding nodes adds capacity, not complexity, through distributed edge architecture that eliminates central bottlenecks.
90% Cost Reduction
Per-node pricing with no per-metric charges eliminates volume-based anxiety - predictable costs that scale with infrastructure value, not metrics volume, achieving dramatic savings versus traditional platforms.
Unlimited Cardinality by Design
Monitor ephemeral containers, microservices, and dynamic workloads without dimension limits - built-in protections prevent runaway metrics while enabling comprehensive visibility at scale.
80% MTTR Improvement
Anomaly Advisor surfaces root cause in top 30-50 metrics from thousands - AI explains issues in plain language, enabling rapid resolution without manual correlation during incidents.
Zero Configuration Required
60 seconds from install to insight - 800+ integrations auto-discover services, algorithmic dashboards adapt automatically, and ML trains without tuning, empowering every engineer with expert-level visibility.

October 5, 2026
Distributed Tracing In Netdata: OpenTelemetry Traces
Netdata now ingests OpenTelemetry traces over OTLP on the same Agent that collects your metrics and logs. Spans are stored and indexed on your own infrastructure and explored in the new Traces tab in Netdata Cloud.

October 3, 2026
Who Built This Dashboard, and Are They Still Here?
Your server monitoring dashboard shouldn't be a DIY project. Netdata charts every metric automatically — no query languages, no dashboards to build, ever.
September 8, 2026
Infrastructure Knowledge For AI Root Cause Analysis
Netdata AI now learns your infrastructure the way a new SRE would: a shared context document your team writes, and a memory layer built from conversations that gets more accurate every time you use it.