




 Red Hat Monitoring & Observability
Transform OpenShift Monitoring with Edge Intelligence
Netdata delivers per-second visibility across Red Hat OpenShift, RHEL, and hybrid infrastructures with 90% cost reduction, zero-configuration deployment, and ML-powered anomaly detection on every metric. Eliminate Prometheus memory exhaustion, Loki query timeouts, and RHACM complexity while maintaining complete data sovereignty.

Why Red Hat Teams Choose Netdata
Purpose-built for Red Hat environments with proven results
90% Cost Reduction
Predictable per-node pricing eliminates surprise bills. No charges for metrics volume, Logs Monitoring (querying logs in place), containers, or users.
True Real-Time Visibility
Per-second metrics with sub-2-second latency. Catch microbursts and transients invisible to 30-60 second monitoring.
ML on Every Metric
18 unsupervised models per metric detect anomalies. Root cause surfaces in top 30-50 results automatically.
Zero Configuration
800+ integrations with auto-discovery. From install to full visibility in 60 seconds. No PromQL, no YAML engineering required.
Complete Data Sovereignty
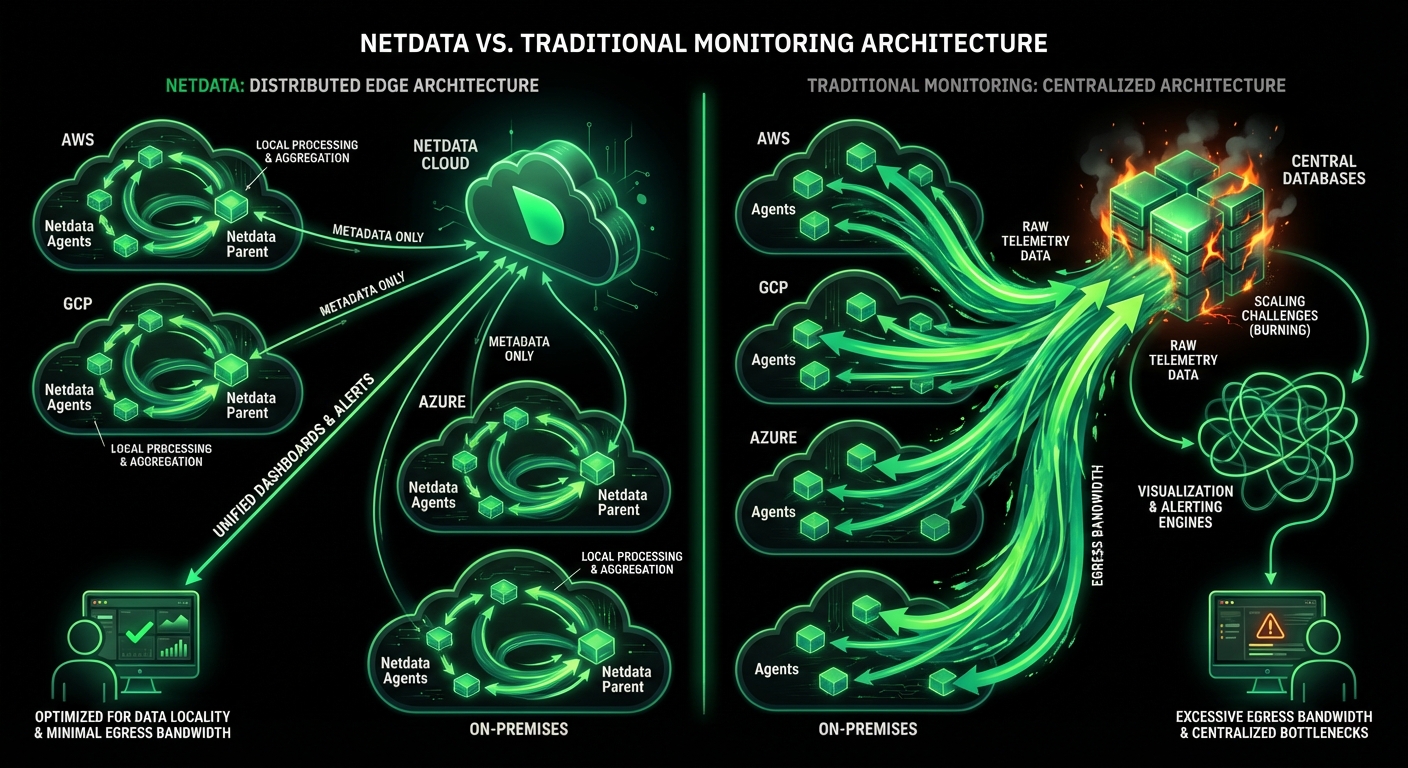
All metrics, logs and traces stay on your infrastructure. Supports GDPR, HIPAA, PCI DSS programs. Only metadata travels to Cloud.
Linear Scalability
Proven from 1 to 100,000+ nodes without architectural changes. Distribute intelligence to the edge instead of centralizing data.
Trusted by Red Hat environments worldwide



Solve Critical Red Hat Monitoring Challenges
Eliminate Prometheus Memory Exhaustion
88% Less RAM
See Benchmark Results

Stop Loki Query Timeouts
90% Cost Reduction
Learn About Zero-Pipeline Logs


Replace RHACM Observability Complexity
50% Less Resources
Compare Multi-Cluster Solutions


Accelerate Troubleshooting with AI
80% Faster MTTR
Explore AI Features


Monitor Everything Without Blind Spots
800+ Integrations
Browse Integrations


Replace SSH with Browser-Based Debugging
Console Replacement
See Netdata Functions


Red Hat Monitoring Solutions Compared
Netdata vs Traditional Red Hat Monitoring
See how Netdata solves critical pain points that plague Prometheus, Loki, and RHACM deployments while delivering superior performance at lower cost.
Capability
Netdata
Traditional (Prometheus/Loki/RHACM)
Data Granularity
✅ Per-Second
Catch microbursts and transients
⚠️ 10-60 Seconds
Miss 90% of operational anomalies
Total Latency
✅ Sub-2 Seconds
Event to insight in real-time
⚠️ 30-120 Seconds
Delayed visibility during incidents
Memory Usage (4.6M metrics/s)
✅ 47 GB
Stable, no OOMKilled pods
❌ 383 GB
Memory pressure, node instability
Configuration Required
✅ Zero for 80%
Auto-discovery, no YAML
❌ Extensive
ServiceMonitors, RBAC, manual setup
ML Anomaly Detection
✅ Every Metric
18 models per metric
❌ Not Available
Manual threshold tuning required
Log Query Performance
✅ Sub-Second
Direct journal access, no timeouts
❌ 504 Errors
Loki fails on 7-30 day ranges
Pricing Model
✅ Per-Node
Per-node pricing, no per-metric charges
❌ Volume-Based
Unpredictable, surprise bills
Data Sovereignty
✅ Complete
All data stays on-premises
⚠️ Limited
Centralized storage, egress costs
Scalability Model
✅ Linear
1 to 100K+ nodes, no redesign
❌ Exponential
Complexity grows with scale
Learning Curve
✅ Zero
No PromQL, no dashboard building
❌ Steep
PromQL, Grafana, YAML expertise
Alert Management
✅ Component-Level
400+ pre-configured alerts
❌ Manual Setup
Alertmanager rules from scratch
Multi-Cluster Maturity
✅ Production-Ready
10+ years, 80K GitHub stars
⚠️ Limited
RHACM has known limitations
Netdata for Red Hat Environments
OpenShift Monitoring Reimagined
Deploy Netdata as DaemonSet for per-node visibility with Parent clusters for centralization. Auto-discover pods, containers, and services with zero configuration.
Native Kubernetes integration with Helm charts
Deploy on OpenShift


Key Benefits for Red Hat Teams
Transform your Red Hat monitoring with proven results
Predictable Economics
Per-node pricing eliminates surprise bills. No charges for metrics volume, Logs Monitoring (querying logs in place), containers, or users.
Instant Deployment
From install to full visibility in 60 seconds. Zero configuration for 80% of integrations.
Proactive Detection
ML anomaly detection on every metric. Root cause surfaces in top 30-50 results automatically.
Compliance Ready
SOC 2 Type 2 certified. GDPR, HIPAA, PCI DSS aligned by design. Complete data sovereignty with on-premises storage.
Team Empowerment
Junior engineers get senior-level visibility. No specialized skills required. AI-powered troubleshooting in plain English.
Unlimited Scale
Proven from 1 to 100,000+ nodes without architectural changes. Linear scalability with distributed edge intelligence.
Complete Visibility
800+ integrations covering infrastructure, containers, applications, network, and hardware. No blind spots, no sampling.
AI-Powered Insights
One-click alert explanations, automated root cause analysis, and natural language queries via Model Context Protocol.

October 3, 2026
Who Built This Dashboard, and Are They Still Here?
Your server monitoring dashboard shouldn't be a DIY project. Netdata charts every metric automatically — no query languages, no dashboards to build, ever.

June 28, 2026
Fleet Observability: Linux Edge Device Monitoring
Learn how edge-resident fleet observability monitors thousands of Linux devices behind NAT, on cellular, and through outages. Read the full guide now!

June 23, 2026
5 Best SolarWinds Alternatives for 2026
Discover the 5 best SolarWinds alternatives for 2026, built for the cloud-native, dynamic infrastructure legacy tools can't handle. Read the guide now!